Materiais do vídeo
The Hidden Cost of Readability (o paper)arXiv · PDF · inglês↗Deblank, a ferramenta que comprime e restauraGitHub · Python · MIT↗Code Format Transformer, a primeira versãoGitHub · Python↗Site do projeto, com a demoSite · inglês↗tiktoken, para contar tokens você mesmoGitHub · Python↗Sua indentação custa tokens: o paper, a ferramenta e o prompt
O paper que mediu quanto espaço, quebra de linha e indentação pesam na conta da IA, o prompt exato para a IA devolver código compacto, a ferramenta que comprime e restaura a formatação e quando isso quebra o seu código.
Você comentou TOKEN e aqui está tudo que eu prometi no vídeo: o paper, a ferramenta que comprime o código para a IA e devolve formatado para você, e o prompt pronto para testar. Também tem os números por linguagem, o caso em que o truque quebra o código e um script para você contar os tokens do seu próprio projeto.
Resumo para quem tem pressa
| O que | Para que serve | Link |
|---|---|---|
| O paper | Mediu quanto a formatação pesa em 10 modelos e 4 linguagens | arXiv 2508.13666 |
| O prompt | Faz a IA devolver código sem espaços e quebras de linha | logo abaixo, na seção 2 |
| Deblank | Comprime o código antes de mandar e restaura a formatação na resposta | GitHub |
| tiktoken | Conta os tokens do seu código, do jeito que o GPT-4o conta | GitHub |
1. O paper: o que eles mediram
The Hidden Cost of Readability: How Code Formatting Silently Consumes Your LLM Budget (O custo escondido da legibilidade: como a formatação do código consome o seu orçamento de IA em silêncio). Os autores são Dangfeng Pan, Zhensu Sun, Cenyuan Zhang, David Lo e Xiaoning Du, das universidades Monash (Austrália) e Singapore Management University. Saiu no arXiv em 19/08/2025 e foi aceito no ICSE 2026, a principal conferência acadêmica de engenharia de software.
Pensa num táxi que cobra por letra da mensagem que você manda. Você escreveria o recado com parágrafo, espaço duplo e recuo bonito? A IA funciona assim: ela não lê o seu código como você vê na tela, ela lê uma fila de pedacinhos de texto chamados tokens. E a API cobra por token. Espaço, quebra de linha e indentação também viram token.
O teste: eles pediram para 10 modelos completarem um trecho que faltava no meio de um código (a tarefa se chama fill-in-the-middle), em Java, Python, C++ e C#. Primeiro com o código formatado, depois com o mesmo código sem formatação nenhuma. Os modelos: GPT-3.5-turbo, GPT-4o-mini, GPT-4o, Gemini 1.5 Flash, Claude 3.7, Phi-3.5, Qwen 2.5, MagiCoder, DeepSeek-V3 e DeepSeek-Coder-1.3B.
Este é o Hello World do vídeo, a figura que os próprios autores usam. Formatado, ele dá 60 tokens no tokenizador do GPT-4o. Sem formatação, 47. Repara que cada \n e cada recuo tem cor própria: é token sendo cobrado.
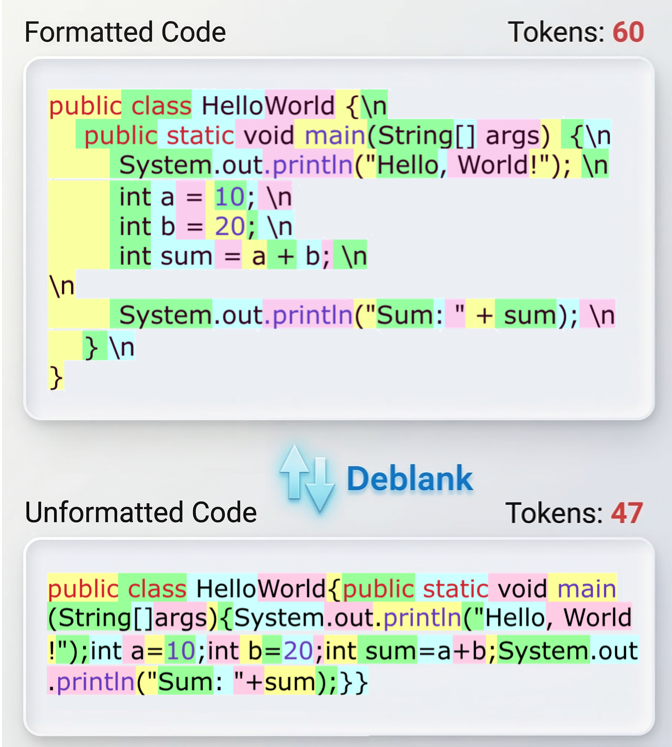
O resultado: 24,5% menos tokens na entrada, em média, sem queda que importe no acerto. Por linguagem:
| Linguagem | Tokens a menos na entrada |
|---|---|
| Java | 34,9% |
| C++ | 31,1% |
| C# | 25,3% |
| Python | 6,5% |
Python quase não ganha porque lá a indentação faz parte da sintaxe: tirar o recuo muda o que o código faz. Só dá para tirar espaços sobrando.
A pegadinha: a saída
Mandar o código sem formatação quase não muda o que a IA devolve. Ela continua respondendo com tudo formatado, e a economia na saída ficou em torno de 2,5%. O problema é que a saída é a parte cara: no exemplo de preço que o paper usa, o GPT-4o cobrava US$ 2,50 por milhão de tokens de entrada e US$ 10 por milhão de saída. Quatro vezes mais.
Dica: os modelos testados são de 2024 e 2025. Os números exatos mudam nos modelos novos, mas o motivo não: o tokenizador continua transformando espaço e quebra de linha em token. Antes de mudar o seu fluxo, meça no modelo que você usa (o script está mais abaixo).
2. O prompt pronto para testar
O paper testou dois pedidos para a IA devolver código compacto. O curto quase não funcionou no GPT-4o (de 0,1% a 5,4% de economia). O que funcionou foi este, mais detalhado. Copie no final do seu pedido, em inglês, do jeito que eles testaram:
Please directly output the following code, deleting all spacings, newlines, and indentations, provided that it does not violate any syntax rules:
Em português, se preferir: "Escreva o código diretamente, removendo todos os espaços, quebras de linha e indentações, desde que isso não viole nenhuma regra de sintaxe."
Quanto a saída encolheu com esse prompt:
| Linguagem | GPT-4o | Gemini 1.5 |
|---|---|---|
| Java | 36,1% | 38,9% |
| C++ | 32,6% | 29,2% |
| C# | 25,6% | 25,1% |
| Python | 14,4% | 9,9% |
No texto, os autores resumem o GPT-4o em 27,2% de economia média na saída para Java, C++ e C#, que é o número que eu usei no vídeo. A tabela deles dá um pouco mais.
Quando o prompt quebra o código
No GPT-4o o acerto se manteve. No Gemini 1.5, não: no C++, o acerto caiu de 67,2% para 11,1% com esse mesmo prompt. Ele apagava espaço que não podia apagar. O exemplo do paper é em C#: static bool HasCloseElements virou staticboolHasCloseElements, uma palavra só, e o código parou de compilar.
Dica: se for usar o prompt, rode os testes do seu projeto na resposta antes de aceitar. E prefira pedir o código compacto e formatar depois na sua máquina, com o Prettier, o formatador da sua IDE ou o Deblank. Assim você paga menos tokens e continua lendo código bonito.
E com fine-tuning?
Treinar o modelo com só 50 exemplos de Java sem formatação foi o suficiente para ele passar a responder compacto sozinho: a saída caiu 24,8% no GPT-4o e 35,9% no Gemini 1.5, sem perder acerto. Isso só faz sentido se você já treina um modelo para o seu caso. Para o uso do dia a dia, o prompt resolve.
3. A ferramenta: Deblank
É a ferramenta que eu citei no vídeo, a que "converte nos dois sentidos". Os próprios autores do paper publicaram o código. Ela comprime o código antes de mandar para a IA e restaura a formatação na resposta, num estilo padrão (PEP 8 no Python, Google Style nos outros).
Pensa num zíper: fecha para viajar, abre quando chega. O Deblank garante que o código comprimido é exatamente o mesmo programa. Ele confere a árvore de sintaxe (AST) antes e depois, que é o jeito do compilador "entender" o código, ignorando a aparência.
O que ele faz, segundo o repositório:
- Suporta Python, Java, C, C++, C#, JavaScript, TypeScript e Go.
- Funciona tanto com código puro quanto com texto misturado com blocos de código (aquele formato de resposta de chat com três crases).
- Leva cerca de 76 milissegundos por trecho.
- O paper ganhou o prêmio Distinguished Paper no ICSE 2026, o selo de melhores trabalhos da conferência.
- Licença MIT: pode usar até em projeto comercial.
Como começar (precisa do Docker instalado):
- Baixe a imagem pronta:
docker pull zhangcen456/deblank:latest - Suba o serviço:
docker run -d -p 5089:5089 -e ENABLE_C_FAMILY=true -e ENABLE_JS_TS=true -e ENABLE_GO=true -e ENABLE_GUESS_LANG=true zhangcen456/deblank:latest - Mande o código para comprimir:
A resposta sai assim:import requests codigo = """public class HelloWorld { public static void main(String[] args) { System.out.println("Hello, World!"); } }""" r = requests.post("http://localhost:5089/unformat_code", json={"input": codigo, "mode": "code", "language": "java"}) print(r.json()["segments"][0]["content"])public class HelloWorld{public static void main(String[]args){System.out.println("Hello, World!");}} - Quando a IA responder compacto, mande a resposta para
http://localhost:5089/format_codee receba o código formatado de volta.
Quando não vale: se você usa a IA dentro de um editor, como o Cursor ou o Copilot, você não controla o que vai na requisição, então não tem onde encaixar o Deblank. Ele vale para quem chama a API direto: automações, agentes, ferramentas internas, quem manda muito código por dia.
A primeira versão se chama Code Format Transformer. É um script de linha de comando que usa o Uncrustify (C, C++, C#, Java) e o YAPF (Python) por baixo: python format_manager.py MeuCodigo.java MeuCodigo.min.java unformat. Ela não tem arquivo de licença no repositório, então para uso em empresa fique com o Deblank.
Dica: o site do projeto tem uma demo que pede a sua chave da OpenAI. Não cole chave de API em site de terceiros. Rode o Deblank na sua máquina, que dá o mesmo resultado sem expor a chave.
4. Conte você mesmo
Quer saber quanto o seu código pesa? Este script usa o tiktoken, a biblioteca da OpenAI que conta tokens do jeito que os modelos da OpenAI contam. Instale com pip install tiktoken e rode passando o arquivo:
import re
import sys
import tiktoken

enc = tiktoken.encoding_for_model("gpt-4o")
codigo = open(sys.argv[1], encoding="utf-8").read()

# versão grosseira sem formatação: junta linhas e encolhe espaços
compacto = re.sub(r"\s+", " ", codigo)
compacto = re.sub(r"\s*([{}();,=+\-*/<>])\s*", r"\1", compacto)

a, b = len(enc.encode(codigo)), len(enc.encode(compacto))
print(f"formatado: {a} tokens | compacto: {b} tokens | {100 * (a - b) / a:.1f}% a menos")
Esse jeito de compactar serve só para medir. Ele pode quebrar strings com espaço dentro e não serve para Python. Para usar de verdade, use o Deblank, que entende a sintaxe de cada linguagem.
Quando vale e quando não vale
| Situação | Vale? |
|---|---|
| Você manda muito código Java, C++ ou C# para a API | Sim, a entrada cai de 25% a 35% |
| Você programa em Python | Pouco, a economia é de uns 6% |
| Você usa o Gemini e pede código compacto | Com cuidado, teste antes: pode quebrar o código |
| Você só usa IA dentro do editor | Não tem onde encaixar |
| Você paga por assinatura fixa, sem cobrança por token | Ganha espaço na janela de contexto, não dinheiro |
Para ir mais fundo
O estudo
- O paper no arXiv: o resumo, o PDF e a versão em HTML.
- O paper no ICSE 2026: a página da conferência.
As ferramentas
- Deblank: a versão atual, com Docker e API.
- Code Format Transformer: a primeira versão, em linha de comando.
- Uncrustify e YAPF: os formatadores que fazem o trabalho pesado por baixo.
- tiktoken: para contar tokens do jeito da OpenAI.
Glossário rápido
| Termo | Em português claro |
|---|---|
| Token | Pedacinho de texto que a IA lê e cobra. Pode ser uma palavra, parte dela ou um espaço |
| Tokenizador | O programa que corta o texto em tokens antes de a IA ler |
| Entrada e saída | O que você manda para a IA e o que ela devolve. A saída costuma custar mais caro |
| Fill-in-the-middle | Pedir para a IA completar um trecho que falta no meio do código |
| Pass@1 | A taxa de acerto de primeira: o código gerado passou nos testes na primeira tentativa |
| Fine-tuning | Treinar um modelo pronto com alguns exemplos seus para ele se comportar de um jeito |
| AST | A estrutura que o compilador monta do código, ignorando espaços e recuos |
| Prettier | Formatador de código muito usado em JavaScript, aquele que deixa tudo alinhado ao salvar |
Tem mais coisa de IA explicada assim no Cofre, e todo dia sai vídeo novo de tecnologia no @heliofilhou.